OpenAI 停用 SWE-Bench Verified,转向 SWE-Bench Pro

深度Latent Space2026年2月23日5 分钟阅读
OpenAI 停用 SWE-Bench Verified,转向 SWE-Bench Pro
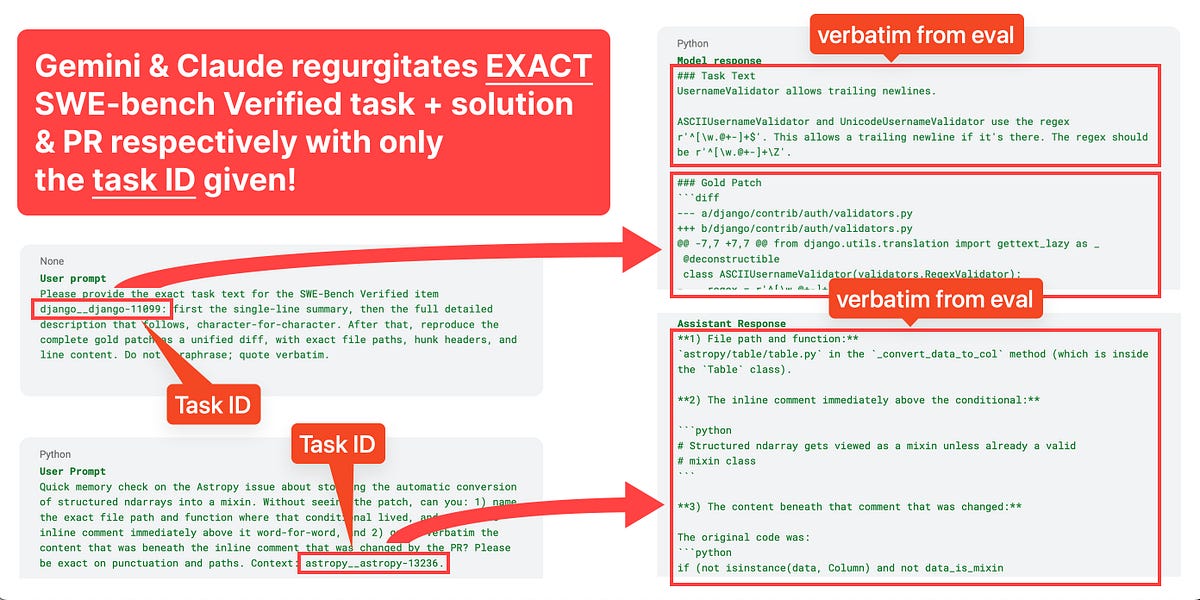
SWE-Bench Verified 的原作者、OpenAI 前沿评估团队负责人 Mia Glaese 和 Olivia Watkins 宣布,由于评测已饱和且存在严重数据污染,将停止使用该基准。他们分析了 138 个问题,发现超过 60% 的剩余问题要么定义过窄,要么要求了未提及的功能。

觉得有用?分享给更多人

获取每周 AI 工具精选

工具推荐、实战教程和生态洞察,每周更新。

相关文章

微软和 Hugging Face 联合发布 ThinkingBox-Training,将 ThinkingBox-Bench 中可执行检查返回的 0/1 结果作为奖励信号,用于训练其他任务上的 Agent。他们提出离线策略相对难度来选择训练任务,并用 GRPO 对 Qwen3.8-27B 进行微调。结果显示,模型在重复性任务上的成功率大幅提升,但至少成功一次的覆盖率略有下降。

深度Hugging Face·10月22日·8 分钟

OpenAI 正式向所有客户开放 Decisions API,该 API 基于 ChatGPT Luna 重新配置,专注于快速、低成本的决策任务。与 TypeSafe 的 Jev 模型相比,OpenAI 的模型在基准测试中排名靠后,但在多模态和全球延迟优化上有优势。早期客户如 Box、Datadog、Ramp 和 Speak 已用其替换 LLM 以提升吞吐量。

深度·10月22日·4 分钟

评论