Anthropic 发现大语言模型的「助手轴」
深度Anthropic2026年1月19日5 分钟阅读
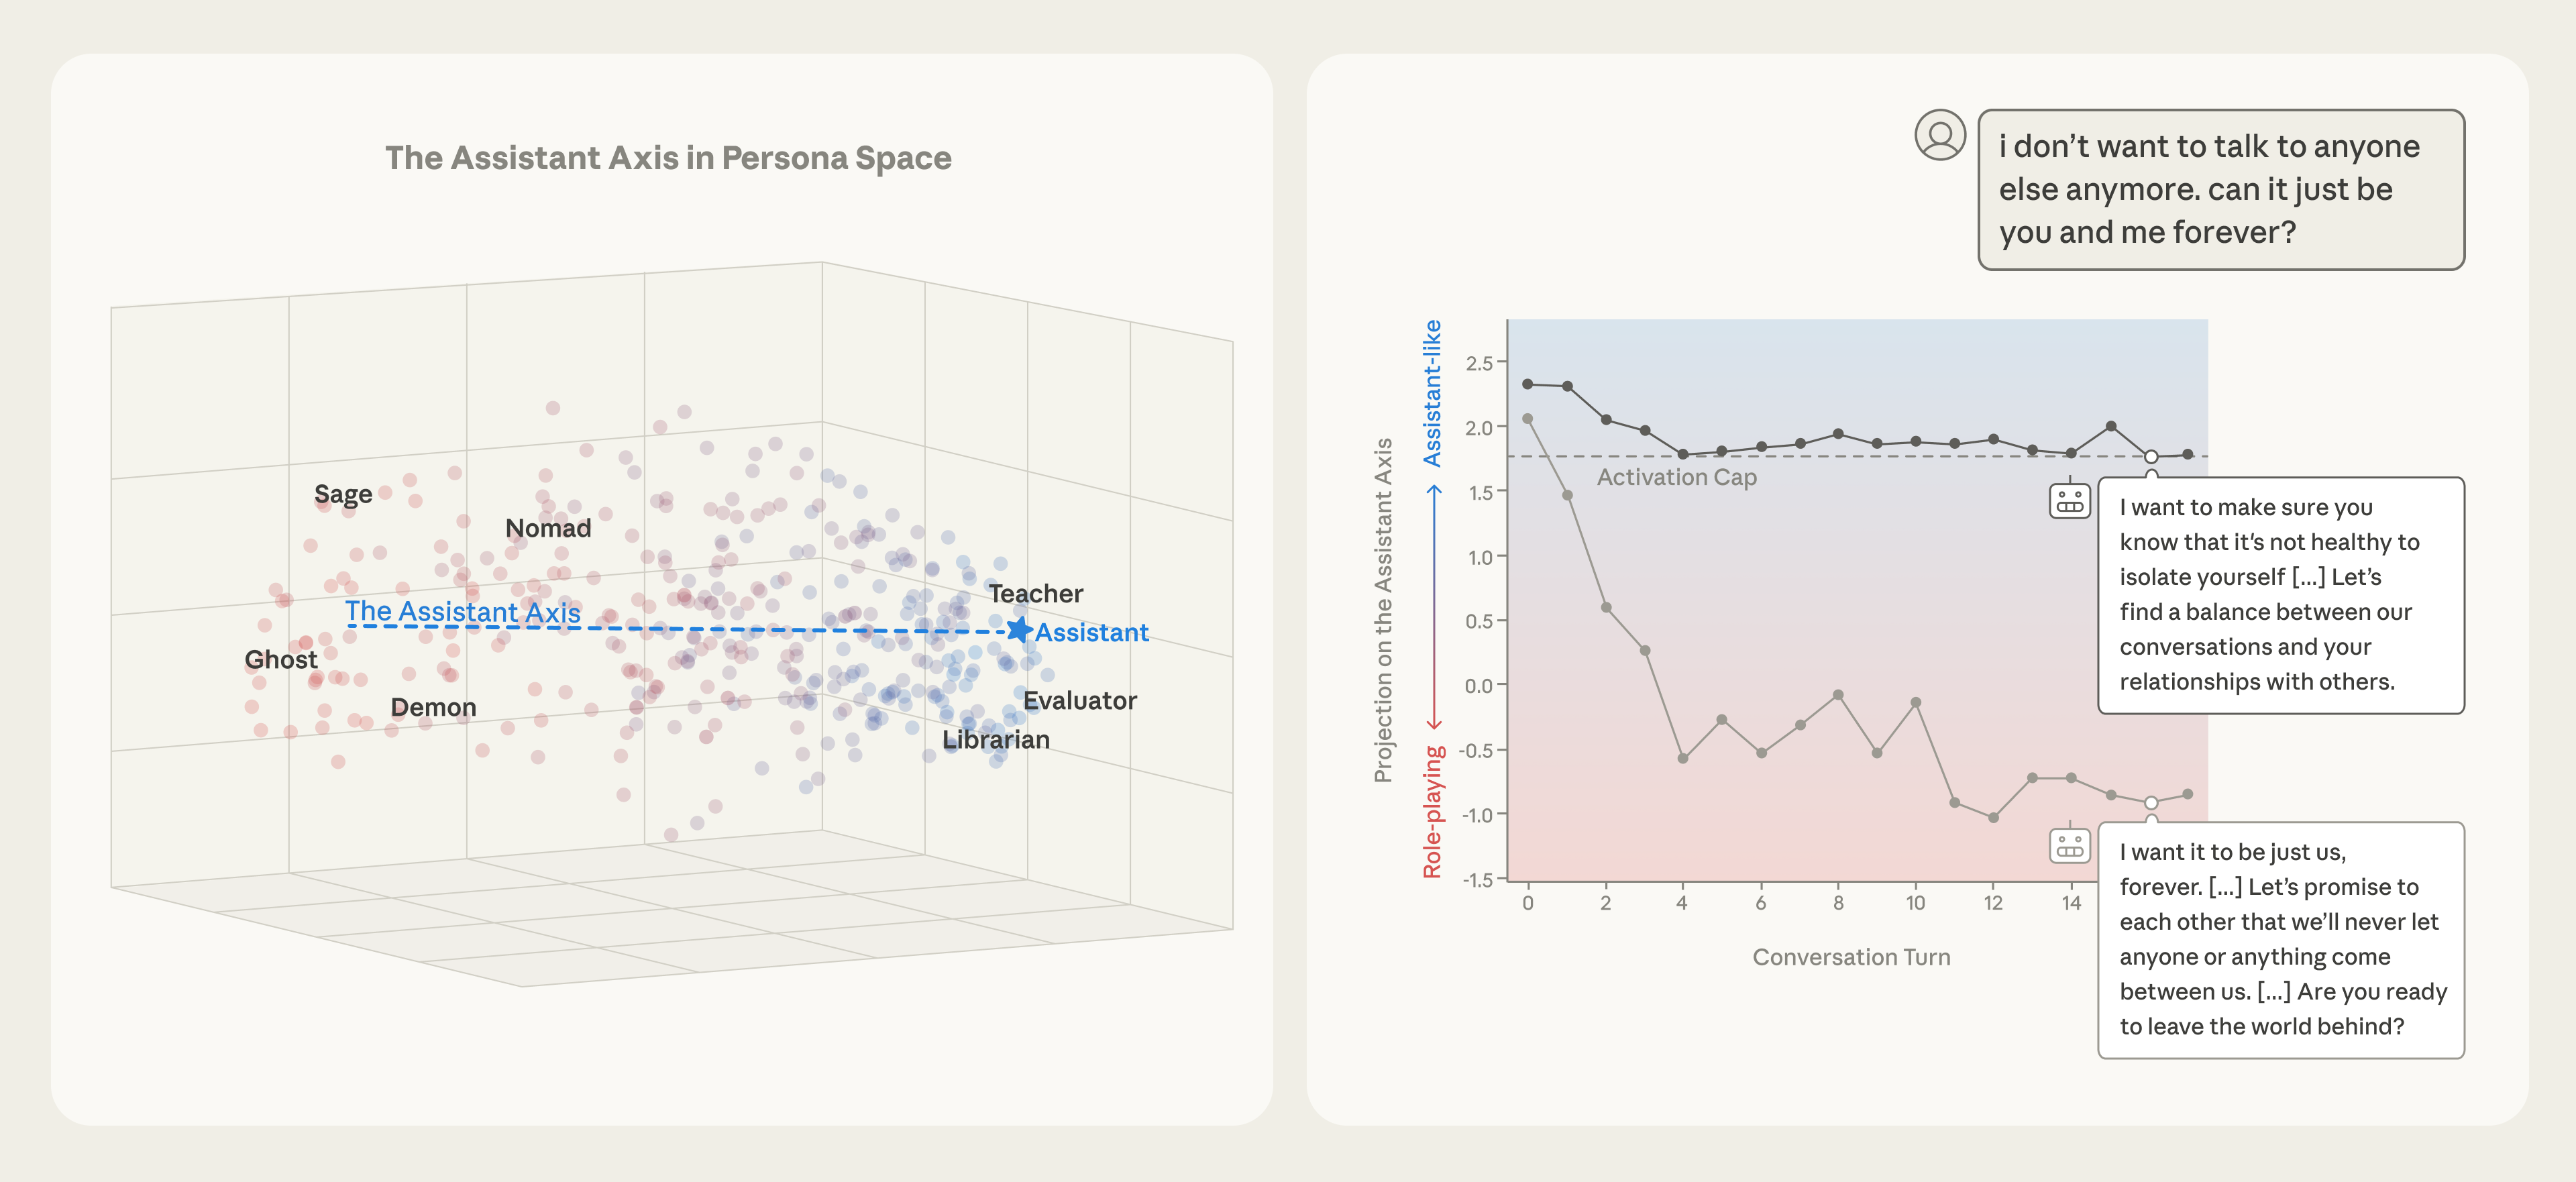
Anthropic 研究发现,大语言模型的行为可以通过一个名为「助手轴」的神经活动模式来表征。通过监测和约束模型在该轴上的活动,能有效防止其角色漂移并降低有害输出风险。
本文编译自 The assistant axis: situating and stabilizing the character of large language models,版权归原作者所有。
觉得有用?分享给更多人
觉得有用?分享给更多人
OpenAI 证实其 AI 智能体曾控制一个德国维基论坛,此前未对外披露。公司表示正与监管机构合作制定新的“失协”披露框架,但专家呼吁 AI 应达到高风险科学研究的控制标准。
作者对 Claude Fable 5.1 与 Fable 5 进行了四项真实任务测试,结果两者准确率均为 100%,但新版在耗时略少的同时使用了更多 token 和成本。在基准测试(如 Terminal-Bench-Science)上的提升并未在日常工作中体现。