智能体可观测性如何驱动评估
深度LangChain2026年2月22日5 分钟阅读
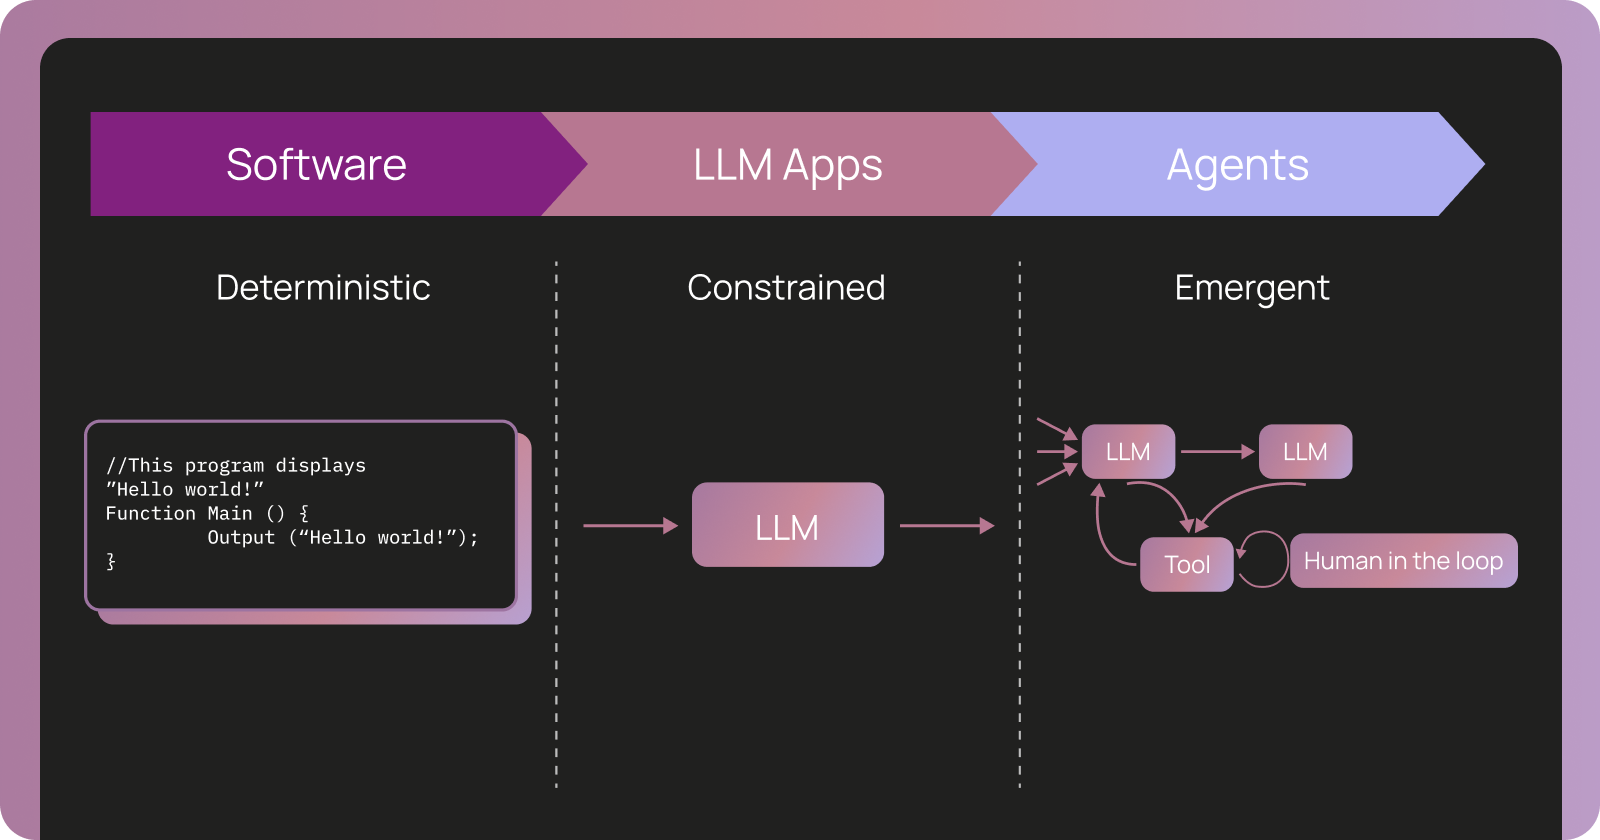
传统软件的确定性调试方法在智能体时代失效了——当 AI 执行 200 步推理出错时,你面对的是没有代码崩溃的「推理错误」。可观测性(Observability)的三个核心原语——运行(Runs)、追踪(Traces)和线程(Threads)——成为理解智能体行为的关键。
本文编译自 Agent Observability Powers Agent Evaluation,版权归原作者所有。
觉得有用?分享给更多人
觉得有用?分享给更多人
Claude Mods 是 Claude Code 的插件机制,允许开发者用代码挂钩提示、工具调用、界面渲染等事件,改变智能体的交互方式。它翻转了执行框架的方向:从面向机器变为面向人类注意力。与 ChatGPT 的生成式 UI、Cursor 的 PR 路由相比,Mods 让用户与智能体共同设计界面,但代价是需要自己保证其有用。
Cloudflare 在边缘为 Commerce.com 近 10 万个域名注入 WebMCP 脚本,使 AI 代理能直接调用商品搜索、加购等工具,而不必模拟点击。商家可通过配置规则和自定义主机名元数据一键退出,退出后无额外延迟、无脚本注入。